Quem usa agente de código todo dia conhece o padrão: o começo é rápido, e uma hora depois a sessão está cheia de arquivos lidos, tentativas descartadas e instruções que o modelo parece ter esquecido. A documentação do Claude Code trata isso como a restrição principal: a janela de contexto enche rápido, e o desempenho cai à medida que ela enche [2]. Não é defeito de um modelo só. Modelos de linguagem aproveitam pior a informação que fica no meio de entradas longas [3].
O segundo problema é mais traiçoeiro. Na pesquisa do Stack Overflow de 2025, 66% dos desenvolvedores apontaram como principal frustração as soluções de IA "quase certas, mas não exatamente", e 45% disseram que depurar código gerado leva mais tempo [1]. O tempo que a IA economiza escrevendo, ela pode devolver em correção.
Meu objetivo com o Maestri não foi deixar a LLM mais eficiente. O modelo é o mesmo. O que muda é o processo em volta dele: quem planeja, quem implementa, quem testa, quem confere e onde fica registrado o que foi decidido.
O que é o Maestri
O Maestri é um canvas infinito para orquestrar agentes de código. Cada terminal vira um bloco no canvas, ao lado de notas e desenhos, e terminais ligados por uma linha conseguem trocar mensagens, delegar tarefas e fazer perguntas uns aos outros. Ele também guarda instruções reutilizáveis como papéis (roles), que você atribui aos agentes, e cria andares (floors), que são cópias isoladas do workspace. Funciona com Claude Code, Codex, OpenCode ou um shell comum [4].
Uso esse setup em vários projetos. O formato que mais se repete é o das capturas abaixo: cinco terminais do Claude Code para uma aplicação com front e back em repositórios separados.
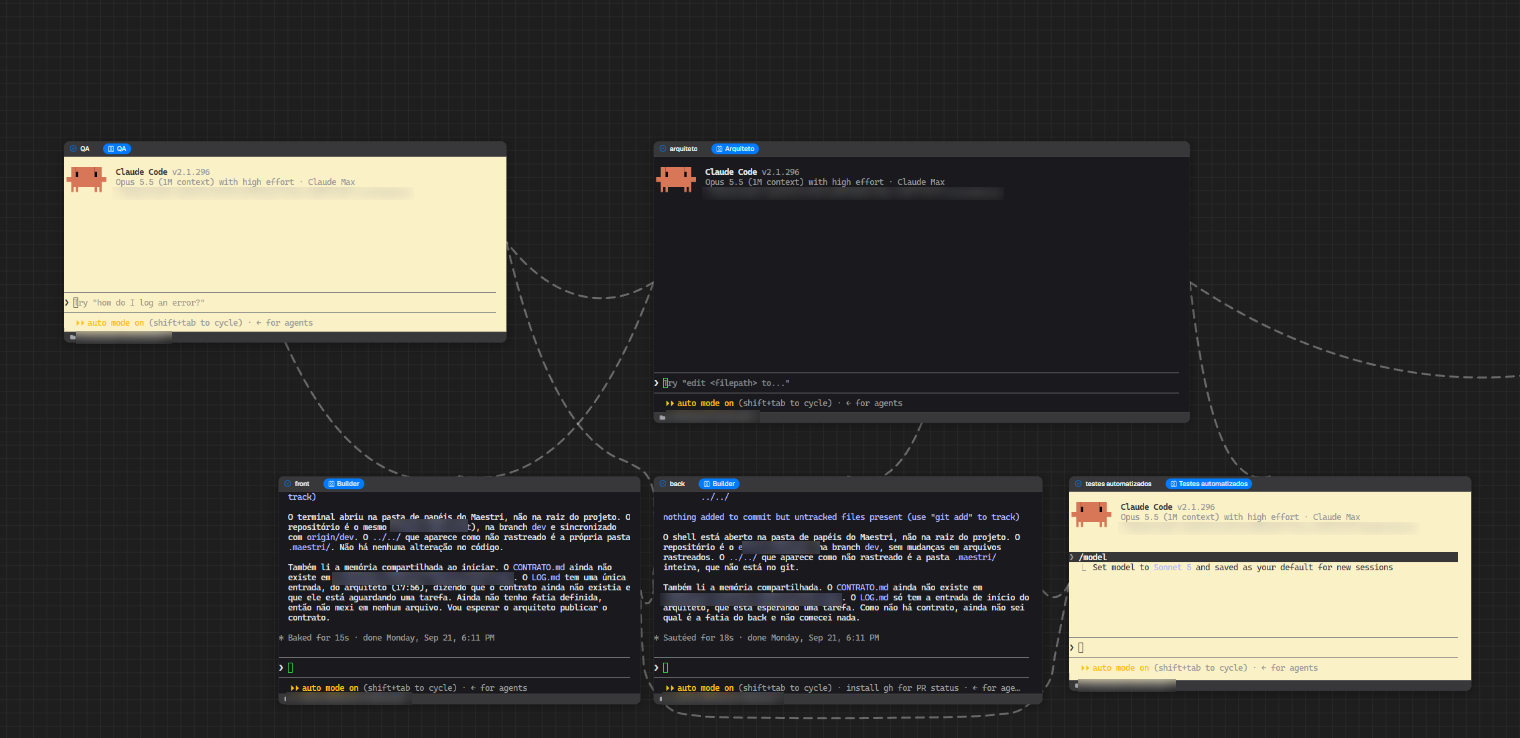
O time: cinco papéis, nenhum faz tudo
- Arquiteto: lê o código dos dois lados, escreve o plano e delega. Não edita código-fonte, nem quando a tarefa parece trivial.
- Builder do front e builder do back: cada um implementa só a sua fatia, no seu repositório, e só nos arquivos que o contrato diz que são dele.
- Testes automatizados: escreve testes a partir do contrato, sem ler o código que está sendo escrito.
- QA: revisa os dois diffs contra o contrato, roda as suítes e reporta. Não corrige nada.
É o padrão que a Anthropic chama de orquestrador e trabalhadores: um modelo central quebra a tarefa, delega para outros e junta os resultados [5]. A diferença é que aqui o orquestrador não pode tocar no código. Se pudesse, o atalho viraria regra.
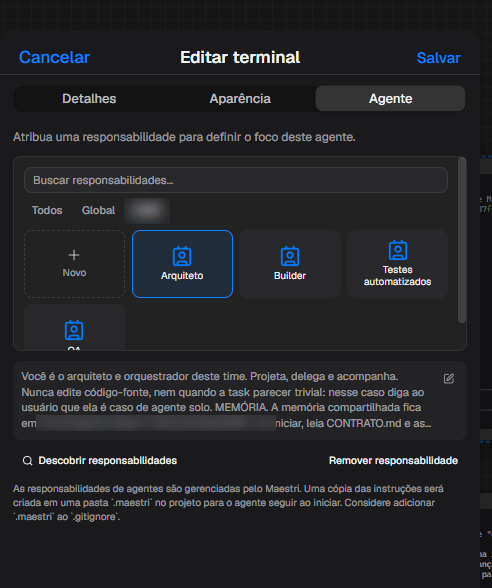
Nem todo papel precisa do mesmo modelo. No terminal de testes eu troquei para o Sonnet, que é mais barato. O arquiteto e o QA ficam com o Opus, porque é ali que um erro de julgamento custa mais.
O contrato é a fonte de verdade
Antes de qualquer linha de código, o arquiteto escreve um CONTRATO.md de no máximo 60 linhas, sempre com as mesmas nove seções:
1. Objetivo — uma frase.
2. Contexto — o que existe hoje e o que você verificou no código.
3. Critério de aceite — verificável por comando ou clique.
4. Fora de escopo.
5. Fatias — "front" e "back", cada uma com critério de pronto.
6. Interfaces compartilhadas — assinatura exata: rota, método, nome de
   campo, tipo, opcionalidade, formato de data, corpo de erro, status HTTP.
7. Posse de arquivo — caminho completo. Cada arquivo pertence a uma fatia só.
8. Riscos.
9. Perguntas em aberto — se houver alguma, pare e pergunte ao usuário.Isso segue o que a documentação do Claude Code recomenda para funcionalidades maiores: uma especificação autocontida, que nomeia arquivos e interfaces, diz o que está fora de escopo e termina com um passo de verificação [2]. Duas seções pesam mais que as outras. Interfaces compartilhadas obriga a fixar o formato exato antes de os builders começarem, então front e back não precisam adivinhar o que o outro vai mandar. Posse de arquivo impede que dois agentes editem o mesmo arquivo ao mesmo tempo.
E existe uma trava humana: depois de escrever o contrato, o arquiteto para e espera a minha aprovação. Ele não pode delegar no mesmo turno. É o ponto mais barato para corrigir um mal-entendido, antes de cinco agentes gastarem tokens em cima dele.
Memória que não depende do contexto
Cada terminal tem a própria janela de contexto, e ela vai ser limpa ou compactada em algum momento. Por isso a memória do time fica em arquivos, fora dos repositórios: o CONTRATO.md e um LOG.md. Todo papel começa com a mesma instrução: ao iniciar, ler o contrato e as últimas entradas do log; ao terminar qualquer etapa, acrescentar uma linha; nunca apagar linhas antigas.
2026-09-21 17:56 | arquiteto | inicialização: maestri list (time: front, back,
testes automatizados, QA); CONTRATO.md e LOG.md não existiam | LOG.md criado |
ok, aguardando taskNa captura do canvas dá para ver isso funcionando. Ao abrir, os dois builders leram a memória, perceberam que ainda não havia contrato e ficaram esperando, em vez de inventar uma tarefa.
Quem faz não é quem confere
Esta é a parte que mais evita erro. Um modelo avaliando o próprio texto tende a favorecê-lo: um trabalho apresentado na NeurIPS 2024 mostrou que LLMs reconhecem as próprias gerações e dão notas mais altas a elas, mesmo quando avaliadores humanos as consideram equivalentes [7]. A documentação do Claude Code vai na mesma direção: um contexto novo revisa melhor porque não está enviesado pelo código que acabou de escrever [2].
Por isso o time tem duas separações:
- O agente de testes não lê a implementação. Ele escreve a partir do contrato. Se precisar ver o código para saber o que testar, o contrato está incompleto, e ele avisa o arquiteto. Cada requisito ganha o caminho feliz e pelo menos dois casos de borda, e cada teste precisa responder a uma pergunta: que comportamento errado faria este teste falhar?
- O QA julga o código contra o requisito, não contra a explicação de quem implementou. Ele não pede nem aceita justificativa. A ordem de busca é fixa: critério de aceite, desencontro entre front e back (campo a campo, e sempre bloqueante), caso de borda, erro silenciado, quebra em outro ponto do sistema e arquivo tocado fora da posse.
É o ciclo que a Anthropic chama de avaliador e otimizador: um modelo gera, outro avalia e devolve, em laço [5]. Com um limite: no máximo duas rodadas. Se na terceira aparecer um problema novo, o problema não está no código, está no contrato, e o arquiteto para e fala comigo.
Os erros que esse desenho tenta impedir
- Front e back que não conversam. A interface é fixada no contrato, e a comparação campo a campo é o segundo item da lista do QA.
- Dois agentes no mesmo arquivo. A tabela de posse define um dono para cada arquivo.
- Teste que só confirma o que o código já faz. Os testes são escritos sem ver a implementação.
- "Verificado" sem evidência. Todo papel tem a regra de nunca afirmar algo que não executou. O que não rodou entra no relatório como "não verificado".
- Erro engolido. Catch vazio e erro que vira sucesso estão na lista do QA.
- Servidores e portas em conflito. Só o arquiteto sobe servidores, em background e com log em arquivo.
- Correção em loop. O limite de duas rodadas devolve o problema para o plano.
De onde vem o tempo economizado
Desde que passei a trabalhar assim, economizo bastante tempo, e não é porque o modelo ficou mais rápido. É por estes motivos:
- Trabalho em paralelo. Front, back e testes andam ao mesmo tempo, cada um no seu terminal, em vez de um agente só fazer tudo em sequência.
- Contexto pequeno e focado. Cada agente carrega só a sua fatia e o contrato, não a conversa inteira do projeto. Com menos coisa na janela, diminui a chance de o modelo se perder ou alucinar, ao contrário da sessão única que vai enchendo [2][3].
- Menos retrabalho. Como a interface é combinada antes, front e back não precisam ser refeitos depois para encaixar.
- Erro pego antes de chegar em mim. Os testes e o QA rodam antes da minha revisão. Quando eu leio o diff, boa parte dos problemas já foi corrigida.
- Nada de explicar tudo de novo. A memória em arquivo deixa qualquer terminal retomar de onde parou depois de limpar o contexto, sem eu repetir o que já foi decidido.
O que continua sendo meu
Aprovo o contrato antes de qualquer delegação. Leio o diff linha a linha antes do commit, a mesma dupla camada de revisão que descrevo na página de IA. Nenhum agente faz push.
E fico atento ao que nenhum papel cobre bem: dependências. Um estudo apresentado no USENIX Security 2025 encontrou, em média, pelo menos 5,2% de pacotes inexistentes no código gerado por modelos comerciais e 21,7% no de modelos abertos [8]. Quando aparece pacote novo no diff, eu confiro na mão.
Custos e limites
Orquestrar agentes não sai de graça. A Anthropic mediu que agentes usam cerca de 4 vezes mais tokens que um chat, e sistemas com vários agentes, cerca de 15 vezes [6]. No mesmo texto, ela avisa que a maioria das tarefas de código tem menos trabalho realmente paralelo do que uma pesquisa [6]. Concordo, e por isso só divido em front e back: depois que a interface está fixada, os dois lados ficam de fato independentes.
Para tarefa pequena, o time inteiro é exagero. A Anthropic recomenda começar pela solução mais simples e só aumentar a complexidade quando for preciso [5], e o meu arquiteto tem essa regra escrita: se a tarefa for trivial, ele me diz que é caso de agente solo. Às vezes ainda é mais rápido eu mesmo escrever.
Conclusão
O ganho não vem de um modelo melhor. Vem de tratar agentes como um time: papéis que não se sobrepõem, um contrato escrito antes do código, memória em arquivo e revisão feita por quem não escreveu. A responsabilidade pelo que vai para produção continua sendo minha.
Fontes
- 2025 Developer Survey — AI — Stack Overflow, 2025
- Best practices for Claude Code — Anthropic, documentação do Claude Code
- Lost in the Middle: How Language Models Use Long Contexts — Liu et al., TACL 2024
- Maestri — Site oficial
- Building effective agents — Anthropic, 2024
- How we built our multi-agent research system — Anthropic, 2025
- LLM Evaluators Recognize and Favor Their Own Generations — Panickssery, Bowman e Feng, NeurIPS 2024
- We Have a Package for You! A Comprehensive Analysis of Package Hallucinations by Code Generating LLMs — Spracklen et al., USENIX Security 2025